-
Créée par
 Joachim Dornbusch, dernière mise à jour le nov. 10, 2026
3 min de lecture
Approche de CRISalid
a. Architecture des flux de données existants (11/2026)
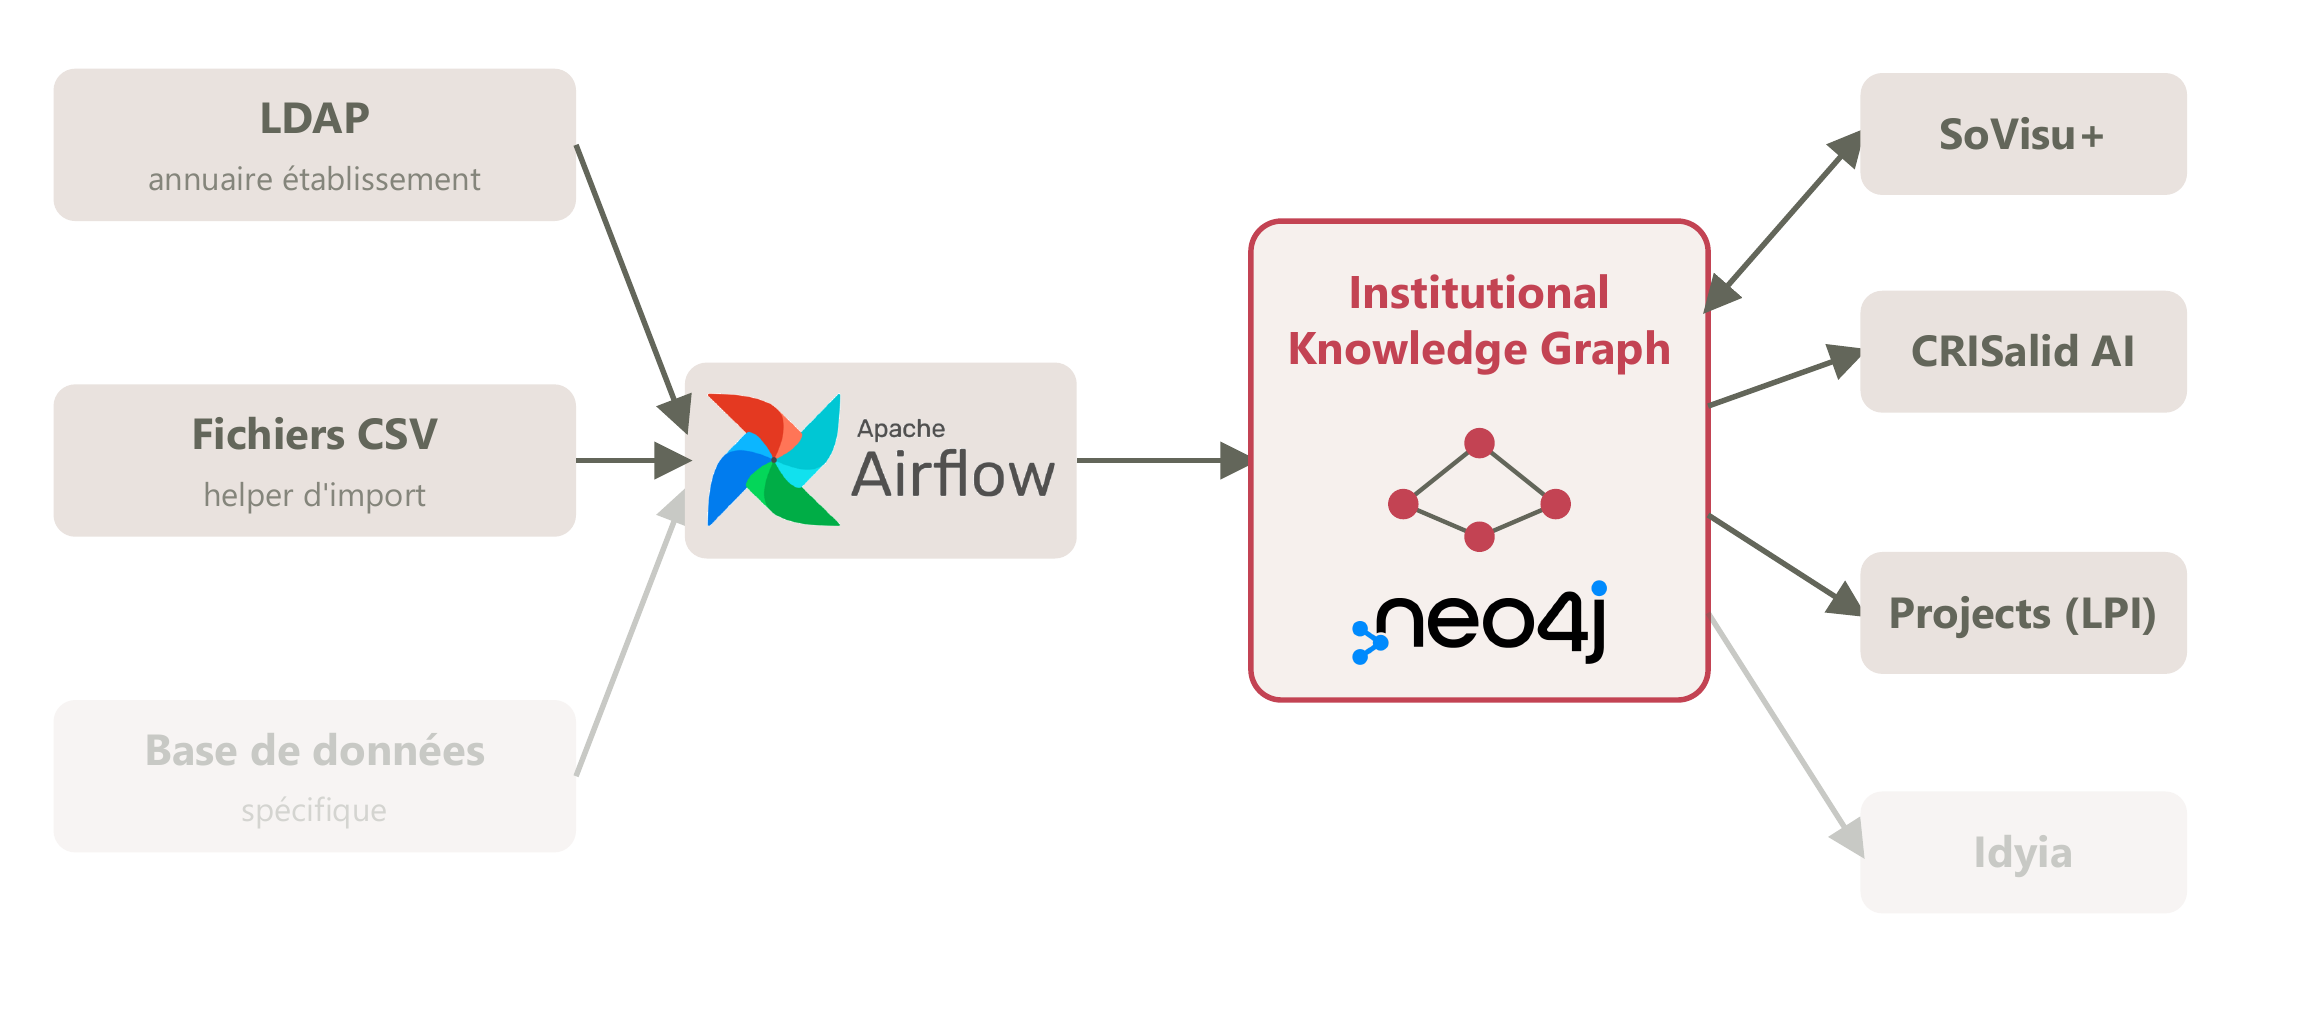
Le système de CRIS proposé par CRISalid est interfacé avec le SI établissement via Apache Airflow, qui permet à chaque établissement d'implémenter des variantes de jobs ou « DAGs » : https://airflow.apache.org/docs/apache-airflow/stable/core-concepts/dags.html
Les DAGs Airflow sont mutualisés au sein du projet CRISalid directory bridge https://github.com/CRISalid-esr/crisalid-directory-bridge.
Selon la situation spécifique de chaque établissement, les DAGs importent le référentiel personnes / structures depuis :
- un annuaire LDAP Supann ;
- un fichier CSV dans un format spécifique :
- une base de données custom ;
- ou une combinaison de ces sources.
Les données sont mises à jour périodiquement et les évolutions déversées dans le bus crisalid-bus (RabbitMQ) : https://crisalid-esr.github.io/crisalid-deployment/map/message_catalog.html#exchange-directory
L'application « Institutional Knowledge Graph » est un middleware qui assure la conversion de ces messages dans un format compatible CERIF 2 et leur inscription dans la base de données graphe Neo4j. https://github.com/CRISalid-esr/crisalid-ikg
Toutes les applications clientes consomment les données depuis le graphe de connaissance par deux moyens :
- crisalid-bus (mises à jour) : https://crisalid-esr.github.io/crisalid-deployment/map/message_catalog.html#exchange-graph
- Apollo (API GraphQL). https://github.com/CRISalid-esr/crisalid-apollo
b. Architecture des flux de données cible
Note : proposition de novembre 2026, à discuter avec les établissements et partenaires CRISalid.
Module de fusion
La nouvelle application, CRISalid Labo, dispose d'un « module de fusion » capable d'importer, de convertir et de réconcilier les données d'un ou plusieurs référentiels personnes / structures :
- fichiers bureautiques (tableurs) utilisés au sein des laboratoires (import unique au démarrage) ;
- annuaire institutionnel, référentiel SINAPS / Cocktail ou base de données de la tutelle hébergeante (import continu) ;
- référentiels des ONR (notamment Reseda, CNRS), voire d'autres tutelles universitaires (import continu).
Ces sources sont réconciliées par des algorithmes avec des règles de priorité fines, paramétrables par établissement, et une historisation intégrale des changements.
Primauté des saisies et rebasing
Les saisies effectuées dans CRISalid Labo (avec workflow de validation le cas échéant) prennent le pas sur toutes les informations importées.
En cas de mise à jour d'une source, les changements validés effectués par les laboratoires et/ou les directions de la recherche sont réappliqués sur les données (« rebasing »).
Les données ainsi fusionnées, corrigées et enrichies sont écrites dans le graphe de connaissance et mises à disposition de tous les modules du système d'information recherche.
Mise à disposition des données
Les données sont remises à disposition de plusieurs façons.
À destination du SI institutionnel
Un point de référence interne est mis à disposition du SI (flux de données REST ou GraphQL, hooks ou messages pour les événements).
Les données mises à disposition incluent un versionnage détaillé des différentes sources, des résultats de fusion et des actions effectuées par les laboratoires / directions de la recherche. Les institutions peuvent utiliser ces données :
- pour fournir aux directions des ressources humaines un journal des écarts et permettre la fiabilisation des référentiels ;
- pour alimenter des plans de mise en qualité des données de référentiel.
À destination du monde
Dans l'optique du respect des engagements COARA, les informations de recherche sont mises à disposition dans un format FAIR : triple store et endpoint SPARQL.
À destination du référentiel Rnest
Pour les structures pour lesquelles l'établissement est référent Rnest, les données sont poussées vers l'API Rnest dans le format attendu (cadre de référence) : alimentation automatique du référentiel.
Par ce biais, les données établissement sont mises à jour dans le RoR.